Strona główna · Blog · Analityka Internetowa
Boty AI w logach serwera – jak sprawdzić, które naprawdę odwiedziły Twoją stronę?
W skrócie
- Gdzie znaleźć logi serwera i czego w nich szukać? Log serwera to dziennik wszystkich żądań kierowanych do witryny.
- Jakie boty AI warto sprawdzać? Lista crawlerów związanych z AI szybko się zmienia, dlatego lepiej opierać się na dokumentacji ich właścicieli niż na zestawieniu skopiowanym kilka miesięcy wcześniej z innego bloga.
- Jak szybko policzyć wejścia botów AI? Mając dostęp do konsoli, pierwszą analizę wykonamy trzema poleceniami.
- Jak zbudowaliśmy do tego własne narzędzie? Powyższe polecenia wystarczają, żeby raz sprawdzić jedną stronę.
Gdy klient pyta, czy ChatGPT zna jego firmę, naturalnym odruchem jest sprawdzenie statystyk ruchu. Problem w tym, że w Google Analytics najczęściej nie zobaczymy niczego. Boty AI nie zachowują się jak użytkownik przeglądarki i nie uruchamiają JavaScriptu, bez którego analityka nie zarejestruje wizyty. Żeby sprawdzić, czy faktycznie pojawiły się na stronie, trzeba zajrzeć do logów serwera.
I właśnie tutaj zaczyna się trudniejsza część zadania. Sam wpis w logu jeszcze niewiele dowodzi, bo nazwa bota znajduje się w polu user-agent, a to zwykły ciąg tekstu, który ustawi praktycznie każdy program. Wpis wyglądający jak wizyta GPTBota nie musi więc oznaczać, że stronę odwiedził crawler OpenAI.
Poniżej znajdziesz cały proces: gdzie szukać logów, jak policzyć w nich wejścia, jak potwierdzić tożsamość bota po adresie IP oraz co z tego wyszło, kiedy zaczęliśmy mierzyć to na stałe u kilkunastu klientów.
Gdzie znaleźć logi serwera i czego w nich szukać?
Log serwera to dziennik wszystkich żądań kierowanych do witryny. Każde wejście zostawia osobny wpis, a w nim adres IP, datę, adres pobieranej podstrony, kod odpowiedzi HTTP oraz nazwę, pod którą przedstawił się program wysyłający żądanie.
Logi prowadzi serwer WWW, a nie WordPress czy inny system zarządzania treścią. Dlatego niezależnie od tego, czy analizujemy sklep, aplikację w Laravelu czy prostą stronę HTML, interesują nas te same informacje. Na własnym serwerze znajdziemy je najczęściej w /var/log/nginx/access.log albo /var/log/apache2/access.log, a przy hostingu współdzielonym w panelu, w sekcji statystyk.
Warto od razu sprawdzić, jak długo hosting przechowuje te pliki. Jeżeli kasuje je po kilku dniach, do jednorazowej diagnozy to wystarczy, ale porównanie miesiąca do miesiąca wymaga regularnego archiwizowania.
Osobny problem pojawia się przy Cloudflare. W takiej konfiguracji w logu zapisze się adres pośrednika zamiast adresu programu, który rzeczywiście wysłał żądanie, więc weryfikując go później, sprawdzimy nie ten adres, co trzeba. Prawdziwy trzeba najpierw odczytać z nagłówka przekazanego przez proxy.
Przeczytaj więcej: Logi serwera – jak wykorzystać je w procesie SEO?
Jakie boty AI warto sprawdzać?
Lista crawlerów związanych z AI szybko się zmienia, dlatego lepiej opierać się na dokumentacji ich właścicieli niż na zestawieniu skopiowanym kilka miesięcy wcześniej z innego bloga.
| User-agent | Właściciel | Po co wchodzi |
|---|---|---|
| GPTBot | OpenAI | zbiera treści wykorzystywane przy trenowaniu modeli |
| OAI-SearchBot | OpenAI | pobiera strony na potrzeby wyszukiwania w ChatGPT |
| ChatGPT-User | OpenAI | wchodzi, gdy o stronę poprosi użytkownik czatu |
| ClaudeBot | Anthropic | zbiera treści wykorzystywane przy trenowaniu |
| Claude-SearchBot | Anthropic | obsługuje wyszukiwanie przy odpowiedziach |
| Claude-User | Anthropic | wchodzi na życzenie użytkownika |
| PerplexityBot | Perplexity | buduje indeks wyszukiwarki |
| CCBot | Common Crawl | tworzy zbiór wykorzystywany później przez wiele modeli |
| Bytespider | ByteDance | zbiera treści dla modeli ByteDance |
| Meta-ExternalAgent | Meta | zbiera treści dla modeli Meta |
Nie wszystkie robią jednak to samo. I to jest znacznie ważniejsze niż sama liczba wejść.
GPTBot, ClaudeBot i CCBot zbierają materiał wykorzystywany przez dostawców modeli, więc ich wizyty mogą przełożyć się na odpowiedzi dopiero w kolejnych wersjach. Inny charakter mają ChatGPT-User i Claude-User, bo ich pojawienie się bywa związane z sytuacją, w której system sięga po konkretną stronę podczas obsługi zapytania użytkownika. Jeżeli interesuje nas bieżąca widoczność, liczy się przede wszystkim ta druga grupa.
Warto też rozprawić się z częstym nieporozumieniem. Google-Extended i Applebot-Extended nie są nazwami crawlerów, tylko tokenami służącymi do określania zasad dostępu do treści w pliku robots.txt. Żaden program nie przedstawia się w ten sposób, bo Google odwiedza strony Googlebotem.
Jak szybko policzyć wejścia botów AI?
Mając dostęp do konsoli, pierwszą analizę wykonamy trzema poleceniami. Pierwsze liczy wystąpienia najważniejszych botów i sortuje wynik od najczęstszych:
grep -oiE “GPTBot|OAI-SearchBot|ChatGPT-User|ClaudeBot|Claude-User|Claude-SearchBot|PerplexityBot|CCBot|Bytespider” access.log \
| sort | uniq -c | sort -rn
Taki wynik mówi nam, ile razy poszczególne nazwy pojawiły się w pliku, ale nie odpowiada jeszcze na pytanie, które podstrony bot odwiedzał. Do tego służy drugie polecenie:
grep -i “GPTBot” access.log | awk ‘{print $7}’ | sort | uniq -c | sort -rn | head -20
Trzecie bywa pomijane, a to właśnie ono nadaje liczbom sens, bo pokazuje kody odpowiedzi zwrócone botowi przez serwer:
grep -i “GPTBot” access.log | awk ‘{print $9}’ | sort | uniq -c
Kod 200 oznacza poprawnie obsłużone żądanie, 404 brak zasobu pod danym adresem, a 403 odmowę dostępu. Jeżeli crawler pojawił się sto razy, ale za każdym razem dostał 404, trudno mówić o stu pobraniach treści.
Nie masz dostępu do terminala? Nie przekreśla to analizy, bo ten sam plik przetworzysz w arkuszu kalkulacyjnym albo w programie do analizy logów.
Dlaczego user-agent nie jest dowodem?
Tu dochodzimy do najważniejszego problemu. User-agent można ustawić samodzielnie i nie potrzeba do tego żadnego specjalistycznego oprogramowania. Wystarczy żądanie w rodzaju:
curl -A “GPTBot” https://twojadomena.pl/
W logu pojawi się wtedy wpis z nazwą GPTBot, mimo że żądania nie wysłał crawler OpenAI. Liczba otrzymana po zwykłym przeszukaniu logów jest więc górnym oszacowaniem, a nie liczbą potwierdzoną.
Zweryfikować da się natomiast adres IP. OpenAI, Perplexity i Google publikują listy adresów, z których wysyłają swoje boty, więc wystarczy sprawdzić, czy adres z logu na takiej liście figuruje. OpenAI udostępnia pliki openai.com/gptbot.json, searchbot.json oraz adsbot.json, Perplexity perplexity.ai/perplexitybot.json, a Google swoje zakresy w serwisie dla deweloperów. Dla GPTBota jest tam dziś 21 zakresów adresów, dla OAI-SearchBota 35, a dla Googlebota 315.
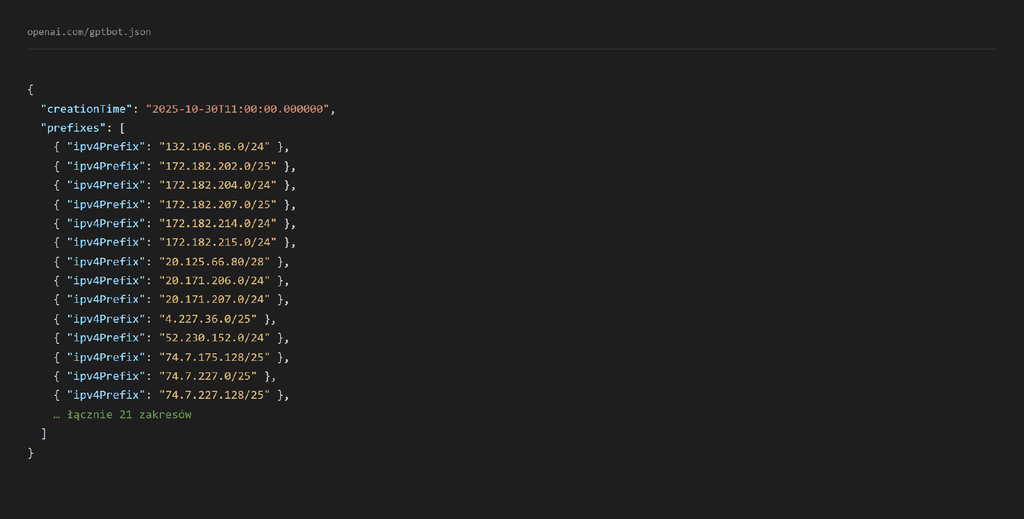
Lista publikowana przez OpenAI – dla GPTBota jedyny wiarygodny punkt odniesienia
Anthropic takiej listy nie udostępnia, więc przy botach Claude’a pytamy system nazw domenowych, do kogo należy adres, i sprawdzamy odpowiedź w drugą stronę:
dig -x 203.0.113.10 +short # z adresu IP do nazwy hosta
dig +short nazwa-hosta.anthropic.com # i z powrotem do adresu
Bot jest prawdziwy tylko wtedy, gdy nazwa należy do domeny dostawcy, a drugie zapytanie prowadzi z powrotem do tego samego adresu. Samo pierwsze polecenie niczego nie rozstrzyga, ponieważ nazwę przypisaną do swojego adresu ustawia jego właściciel.
Obowiązuje przy tym zasada, o której łatwo zapomnieć: brak potwierdzenia to nie to samo co podszywanie się. Kiedy serwer nazw nie odpowiada albo lista nie pobiera się z powodu chwilowej awarii, jedynym uczciwym wynikiem jest status „niezweryfikowane”.
Jak zbudowaliśmy do tego własne narzędzie?
Powyższe polecenia wystarczają, żeby raz sprawdzić jedną stronę. Przy kilkunastu klientach przestają wystarczać, dlatego zbudowaliśmy do tego osobną aplikację. Warto opisać, jak powstawała, bo każdy jej etap wziął się z błędu, który wcześniej popełniliśmy.
Pierwsza wersja mierzyła ruch skryptem osadzonym na stronie, czyli tak samo jak klasyczna analityka. Pokazywała okrągłe zero. Powód był dokładnie ten sam, od którego zaczyna się ten artykuł: crawlery nie wykonują JavaScriptu, więc licznik nigdy się dla nich nie uruchamiał. Trzeba było zejść piętro niżej, na stronę serwera, i zapisywać żądanie w chwili, gdy do niego dociera.
Druga wersja liczyła już poprawnie, ale liczyła nazwy. Kiedy zestawiliśmy wyniki z listami adresów publikowanymi przez OpenAI, okazało się, że część ruchu podpisanego znanymi nazwami przychodzi z adresów, które do tych firm nie należą. Wtedy doszła weryfikacja, a wraz z nią decyzja, żeby werdykt zapisywać razem z wizytą, a nie liczyć go później — zakresy publikowane przez dostawców się zmieniają, więc to samo sprawdzenie wykonane pół roku później dałoby inną odpowiedź.
Trzecia rzecz wyszła dopiero przy dłuższym zbieraniu danych. Serwer co jakiś czas zaczyna nowy plik logu, a przy każdej takiej podmianie statystyki potrafiły policzyć wszystko od początku. Rozwiązaniem było czytanie pliku od zapamiętanego miejsca i rozpoznawanie rotacji po skrócie z jego początku. Przy okazji każda wizyta dostała własny identyfikator złożony ze źródła, numeru pliku i pozycji w bajtach, dzięki czemu ten sam log wgrany przez pomyłkę dwa razy nie podbija już statystyk.
Dziś dane można dostarczyć do aplikacji na cztery sposoby i wybór zależy głównie od tego, do czego mamy dostęp u klienta.
| Metoda | Zaleta | Ograniczenie |
|---|---|---|
| Wtyczka lub kod w motywie | działa bez dostępu do serwera, wdrożenie w kilka minut | widzi tylko żądania, które dotarły do aplikacji |
| Pobieranie logu przez SSH | pełny obraz, łapie także ruch odrzucony wcześniej | wymaga dostępu i klucza, którym trzeba zarządzać |
| Ręczne wgranie pliku | zero konfiguracji, wystarczy do jednorazowej diagnozy | nie da się z tego zbudować trendu |
| Logi z CDN lub usługi ochronnej | widzi ruch, który nigdy nie dotarł do serwera | zwykle płatne, dostępne w wyższych planach |
Najczęściej wystarcza pierwsza, ponieważ klient nie musi niczego udostępniać. Kod przechwytujący startuje na samym początku ładowania strony, zapisuje wyłącznie adres podstrony bez parametrów i wysyła dane w tle, bez czekania na odpowiedź, dzięki czemu serwis nie zwalnia.
Co widać po weryfikacji?
Poniższe liczby pochodzą z jednego ze sklepów, które monitorujemy, i obejmują ostatnie dwa tygodnie.
W tym czasie potwierdziliśmy 1008 wizyt botów AI. Najwięcej wygenerował GPTBot z liczbą 722, za nim OAI-SearchBot z 291 i ClaudeBot z 98. Potwierdzenie znaczy tu dokładnie jedno: adres, z którego przyszło żądanie, mieścił się w zakresie opublikowanym przez OpenAI albo należał do domeny Anthropic po sprawdzeniu w obie strony.
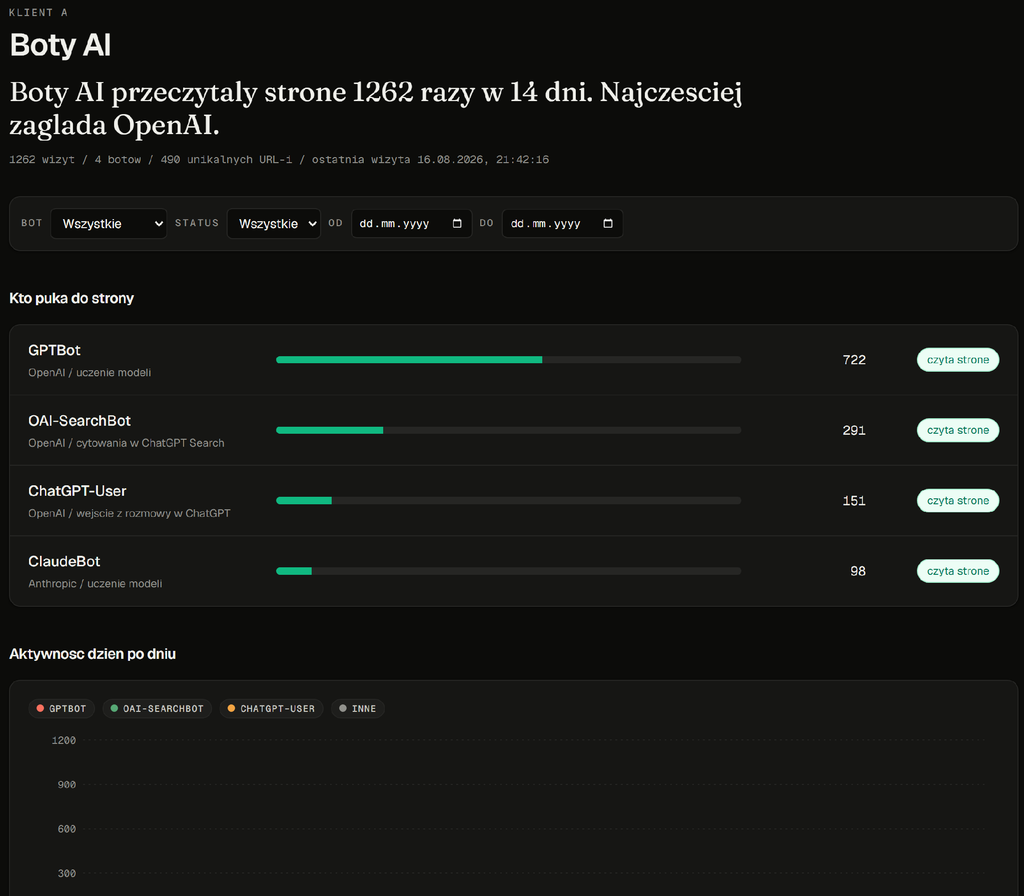
Cztery boty, 1008 potwierdzonych wizyt w dwa tygodnie
Ciekawsze od samej liczby jest jednak to, co te boty pobierały. Na czele nie stoją opisy produktów ani artykuły, tylko /wp-json/oembed/1.0/embed z 260 żądaniami, strona główna ze 194, robots.txt ze 103 i mapa witryny z 53.
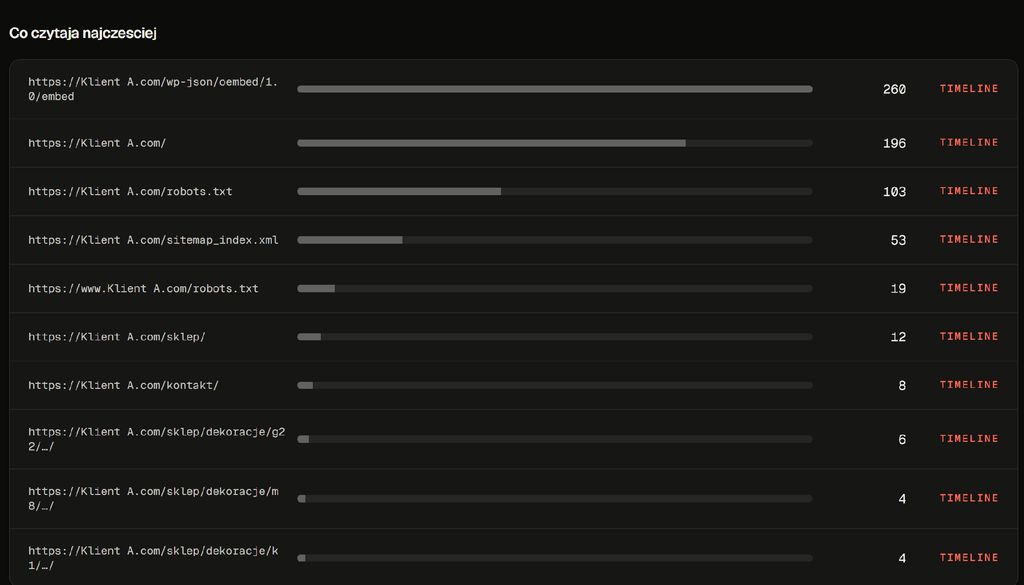
Potwierdzone boty pobierały głównie zasoby techniczne, a nie treść sklepu
Potwierdzona wizyta bota nie znaczy więc jeszcze, że model przeczytał cokolwiek wartościowego. To ta sama pułapka co liczenie samych nazw, tylko piętro wyżej: najpierw sprawdzamy, kto naprawdę przyszedł, a potem po co.
Taki pomiar ma przy tym swoje granice. Dane zbieramy kodem osadzonym na stronie, więc widzimy tylko żądania, które dotarły do aplikacji, a to, co zapora odrzuciła wcześniej, pozostaje niewidoczne. Kategoria „niezweryfikowane” bywa z kolei pojemna z przyczyn czysto technicznych, bo trafia do niej ruch przechodzący przez pośrednika, chwilowo niedostępna lista zakresów oraz boty, dla których dostawca w ogóle nie publikuje adresów. Liczba potwierdzeń jest więc dolną granicą prawdziwego ruchu, a nie jego pełnym obrazem.
Co zrobić, gdy w logach nie ma żadnego bota?
Pusty wynik też jest informacją i najczęściej wskazuje na blokadę. Przyczyny sprawdzamy w kolejności od najczęstszej: reguła w pliku robots.txt dopisana przez wtyczkę SEO, ustawienia usługi ochronnej, kody 403 i 429 świadczące o blokadzie po stronie serwera, treść dorysowywana skryptem, której bot nie zobaczy, oraz brak linków prowadzących do podstrony.
Na szczególną uwagę zasługuje dziś drugi punkt. Od 15 września 2026 Cloudflare domyślnie blokuje boty trenujące i agentowe na nowych domenach oraz na darmowych kontach, w których nikt nie zmienił ustawień. Taka blokada nie zostawia śladu w robots.txt, a przy okazji wycina Googlebota, Applebota i Bingbota, ponieważ pełnią one kilka funkcji naraz.
Trzeba też pamiętać, że logi opisują wyłącznie dostęp do strony. Nie mówią nic o tym, czy model wymienia markę w odpowiedziach, bo to zupełnie osobny pomiar. Regularne wizyty bota przy braku wzmianek wskazują raczej na problem z treścią, a wzmianki bez wizyt oznaczają, że model zna markę z katalogów i mediów, a nie z samej strony.
Najczęstsze pytania
Dlaczego Google Analytics nie rejestruje wizyt botów AI?
Google Analytics nie rejestruje wizyt botów AI, bo crawlery nie uruchamiają JavaScriptu – a to właśnie JavaScript odpowiada za wysyłanie danych do GA. Bot wchodzi na stronę, pobiera HTML i wychodzi, nie wykonując żadnego kodu po stronie przeglądarki. Żeby zobaczyć wizyty botów AI, trzeba zejść na poziom serwera i analizować logi, które rejestrują każde żądanie HTTP niezależnie od tego, czy wykonano skrypty.
Jak zweryfikować tożsamość bota AI po adresie IP?
Tożsamość bota AI po adresie IP weryfikujesz przez sprawdzenie, czy dany adres mieści się w zakresach publikowanych przez dostawcę. OpenAI udostępnia listy adresów w plikach openai.com/gptbot.json i searchbot.json, Perplexity w perplexity.ai/perplexitybot.json. Anthropic nie publikuje listy zakresów – w tym przypadku wykonujesz odwrotne zapytanie DNS: dig -x [adres IP], a następnie weryfikujesz wynik w drugą stronę. Bot jest prawdziwy tylko gdy oba zapytania prowadzą do domeny dostawcy.
Czym różni się bot treningowy od bota indeksującego AI?
Bot treningowy (GPTBot, ClaudeBot, CCBot) zbiera treści używane do trenowania przyszłych wersji modeli – jego wizyty mogą przełożyć się na odpowiedzi AI dopiero za miesiące. Bot indeksujący (OAI-SearchBot, Claude-SearchBot, PerplexityBot) buduje bieżący indeks wyszukiwania AI i decyduje o cytowaniach tu i teraz. Blokada bota treningowego nie wpływa na aktualne cytowania w ChatGPT czy Perplexity – blokada bota indeksującego wyklucza stronę z odpowiedzi AI całkowicie.
Co to jest CCBot i kto go używa?
CCBot to crawler organizacji Common Crawl, która tworzy otwarty zbiór danych z treścią stron internetowych. Zbiór ten jest następnie wykorzystywany przez wiele firm i instytucji akademickich do trenowania modeli językowych, w tym przez OpenAI, Meta i inne organizacje AI. CCBot nie buduje własnego wyszukiwania – dostarcza surowiec treningowy dla ekosystemu AI. Blokada CCBota w robots.txt wyklucza stronę z przyszłych zbiorów Common Crawl.
Jak Cloudflare wpływa na logi botów AI?
Cloudflare jako proxy zapisuje w logach serwera własny adres IP zamiast adresu rzeczywistego bota. Weryfikując wpis z logu, sprawdzasz adres pośrednika, a nie crawlera, co uniemożliwia potwierdzenie tożsamości bota. Prawdziwy adres IP bota trzeba odczytać z nagłówka CF-Connecting-IP lub X-Forwarded-For przekazywanego przez Cloudflare do serwera. Bez skonfigurowania odczytu tych nagłówków analiza logów pod kątem botów AI daje fałszywe wyniki.
Dlaczego Cloudflare domyślnie blokuje boty AI od września 2026?
Od 15 września 2026 Cloudflare domyślnie blokuje boty treningowe i agentowe na nowych domenach oraz na kontach darmowych, w których nie zmieniono ustawień. Blokada działa na poziomie sieci i nie zostawia żadnego śladu w robots.txt. Efektem ubocznym jest blokowanie Googlebota, Applebota i Bingbota, bo pełnią one kilka funkcji naraz. Ustawienie sprawdzasz i zmieniasz w panelu Cloudflare w zakładce AI Crawl Control.
Jakie zasoby najczęściej pobierają boty AI odwiedzając stronę?
Boty AI nie pobierają przede wszystkim treści artykułów – pobierają głównie zasoby techniczne. Na przykładzie monitorowanego sklepu NETIM: na 1008 potwierdzonych wizyt czołowe pozycje zajmowały /wp-json/oembed/1.0/embed (260 żądań), strona główna (194), robots.txt (103) i mapa witryny (53). Potwierdzona wizyta bota nie oznacza więc, że model przeczytał cokolwiek wartościowego – liczy się co bot pobrał, nie tylko czy przyszedł.
Jak długo hosting przechowuje logi serwera?
Czas przechowywania logów serwera zależy od hostingu i jego konfiguracji – przy hostingu współdzielonym zazwyczaj 7–30 dni, przy własnym serwerze VPS lub dedykowanym możesz ustawić dowolny okres. Jeśli planujesz analizę trendu miesięcy do miesiąca, musisz samodzielnie archiwizować logi zanim hosting je usunie. Brak archiwizacji ogranicza analizę do jednorazowej diagnozy bez możliwości porównania danych w czasie.
Czy potwierdzona wizyta bota AI oznacza, że model przeczytał treść strony?
Nie – potwierdzona wizyta bota AI oznacza tylko, że żądanie HTTP dotarło do serwera z zweryfikowanego adresu. Bot mógł pobrać wyłącznie robots.txt, mapę witryny lub odpowiedź 404. Regularne wizyty bota przy jednoczesnym braku wzmianek marki w odpowiedziach AI wskazują raczej na problem z jakością lub strukturą treści niż z dostępnością techniczną. Pełny obraz daje zestawienie odwiedzonych podstron z kodami odpowiedzi HTTP.